NVIDIA Optimalkan DGX Spark untuk Mempercepat Pemrosesan Model AI Campuran Pakar

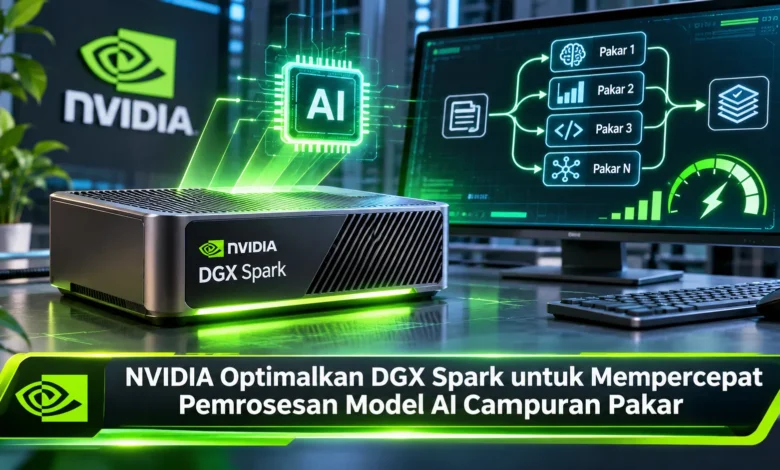
NVIDIA memperkenalkan serangkaian optimalisasi perangkat lunak untuk meningkatkan kecepatan pemrosesan model kecerdasan buatan berbasis Mixture of Experts (MoE) pada DGX Spark. Melalui pembahasan teknis yang dipublikasikan pada 27 Oktober 2026, perusahaan menjelaskan tiga pendekatan utama, yaitu Humming MXFP4, kuantisasi FP8 pada LM head, dan speculative decoding menggunakan NEXTN. Pengujian pada model Ling-3.0-flash menunjukkan peningkatan kecepatan generasi token hingga 42,5 persen dalam evaluasi GSM8K, disertai penurunan latensi rata-rata sebesar 24,5 persen. Inovasi TEKNOLOGI ini menjadi perkembangan penting bagi pengembang yang membutuhkan pemrosesan model AI berukuran besar melalui komputer desktop dengan efisiensi lebih baik.
Peningkatan Performa NVIDIA DGX Spark untuk Model Kecerdasan Buatan
Komputer AI NVIDIA DGX Spark adalah perangkat komputasi berukuran ringkas yang mendukung model AI yang dirancang menangani berbagai pekerjaan AI. Perangkat tersebut dibangun dengan sistem pemrosesan berbasis Grace Blackwell serta menyediakan memori terpadu sebesar 128 GB. Melalui konfigurasi tersebut, pengembang dapat menjalankan sejumlah model besar secara lokal. Walaupun memiliki kemampuan komputasi tinggi, efisiensi perangkat lunak tetap menjadi faktor penting.
Melalui penelitian optimalisasi yang dipublikasikan, NVIDIA menguji berbagai pendekatan untuk mempercepat AI campuran pakar. Arsitektur MoE memiliki banyak komponen komputasi yang disebut experts dan hanya mengaktifkan sebagian pakar untuk setiap token. Strategi komputasi tersebut mendukung pengembangan jaringan saraf berparameter tinggi tanpa harus mengaktifkan seluruh parameter pada setiap langkah. Walaupun lebih selektif dalam perhitungan, perpindahan bobot model dari memori tetap membutuhkan sumber daya.
Mengapa Model MoE Membutuhkan Optimalisasi Memori dan Pemrosesan
Untuk mengidentifikasi hambatan performa, NVIDIA melakukan pengujian pada Ling-3.0-flash dari Inclusion AI. Model tersebut menyimpan total 124 miliar parameter, tetapi hanya mengaktifkan sekitar 5,1 miliar parameter per token. Arsitektur ini dilengkapi sebanyak 512 pakar yang dapat dipilih pada tiap lapisan MoE. Ketika sistem menjalankan lapisan MoE, sistem mengaktifkan delapan routed experts dan satu pakar bersama. Mekanisme pemrosesan ini memberikan fleksibilitas komputasi.
Temuan dari proses profiling mengidentifikasi keterbatasan pemrosesan akibat akses memori. Dalam kondisi tersebut, waktu tidak hanya dihabiskan untuk perhitungan matematika. Proses inferensi membutuhkan akses terhadap data numerik untuk menjalankan lapisan model. Dua bagian yang paling menonjol adalah pemrosesan routed experts serta LM head. Untuk mengatasi hambatan ini, NVIDIA memanfaatkan beberapa metode peningkatan efisiensi inferensi. Tujuannya adalah meningkatkan throughput tanpa sekadar menambah perangkat keras.
Cara NVIDIA Mengoptimalkan Kernel MoE Menggunakan Humming
Teknik peningkatan performa pertama adalah penggantian backend pakar dengan Humming. Sebelum pembaruan diterapkan, Ling-3.0-flash menggunakan backend FlashInfer MXFP4. Tim pengembang selanjutnya menggantinya dengan pustaka Humming. Pustaka ini menggunakan NVIDIA CUDA Runtime Compilation atau NVRTC untuk menghasilkan kernel yang disesuaikan dengan kebutuhan model. Berkat penyesuaian terhadap bentuk operasi, kernel lebih sesuai dengan ukuran komputasi model. Keunggulan lainnya adalah penyusunan kernel secara lebih spesifik.
Melalui pengukuran performa tertentu, NVIDIA menggunakan masukan sepanjang 32 ribu token serta hasil generasi sepanjang 2K token pada konfigurasi satu permintaan sekaligus. Dengan backend awal, throughput tercatat 36,09 token setiap detik. Setelah Humming diaktifkan, pemrosesan mencapai 39,45 token per detik. Peningkatan performa ini setara dengan kenaikan 9,3 persen. Walaupun peningkatannya tidak mencapai puluhan persen, hasil tersebut membantu mengurangi beban langkah decoding.
NVIDIA Optimalkan LM Head untuk Mempercepat Generasi Token
Optimalisasi kedua diterapkan pada bagian proyeksi keluaran model. Komponen proyeksi akhir ini berfungsi sebagai sistem penentu peluang keluaran berdasarkan kosakata. Untuk arsitektur AI tersebut, lapisan keluaran melibatkan kosakata sebanyak 157.184 token dengan dimensi tersembunyi sebesar 2.560. Dalam sistem awal, bobot LM head disimpan dalam format BF16. Karena bobot perlu dibaca untuk setiap token, proses decoding menghadapi beban transfer data tambahan.
Sebagai solusi terhadap beban memori, NVIDIA menggunakan pendekatan online FP8 quantization. Metode pengurangan presisi ini menekan volume akses memori pada bagian keluaran model. Berkat representasi delapan bit, volume pembacaan bobot lapisan tersebut berkurang sekitar setengahnya. Setelah dikombinasikan bersama backend Humming, model mampu menghasilkan 43,94 token per detik dalam pengujian sintetis yang sama. Hasil performa tersebut menggambarkan kenaikan throughput sebesar 21,7 persen terhadap sistem pembanding.
Penerapan Multi Token Prediction pada NVIDIA DGX Spark
Optimalisasi terakhir yang diuji adalah multi-token prediction atau MTP speculative decoding menggunakan NEXTN. Jika dibandingkan dengan optimalisasi kernel serta memori, metode ini berfokus mengurangi jumlah langkah decoding. Model yang dievaluasi telah dilengkapi mekanisme NEXTN yang dapat berfungsi sebagai model draft. Melalui konfigurasi yang diuji, sistem memprediksi tiga token terlebih dahulu kemudian menilai beberapa kandidat melalui satu putaran verifikasi. Kandidat yang lolos pemeriksaan menjadi bagian dari respons yang dihasilkan. Pendekatan speculative decoding dapat meningkatkan jumlah token per detik apabila tingkat penerimaan token memadai.
Pada pengujian sintetis, kombinasi ketiga optimalisasi mencapai kecepatan 102,88 token setiap detik. Pencapaian pengujian ini menggambarkan percepatan 185,1 persen dibandingkan konfigurasi awal. Namun demikian, hasil ini tidak mewakili seluruh jenis pekerjaan. Sebagai evaluasi tambahan, NVIDIA menjalankan pengujian pada 1.319 soal GSM8K. Berdasarkan hasil benchmark ini, throughput naik dari 37,81 menjadi 53,89 token per detik. Berdasarkan perbandingan tersebut, peningkatan throughput mencapai 42,5 persen.
Di samping menghasilkan keluaran lebih cepat, kombinasi optimalisasi tersebut mempercepat respons keseluruhan. Pada seluruh pertanyaan yang diuji, waktu respons rata-rata berkurang dari 15,21 detik ke 11,49 detik. Perubahan tersebut setara dengan pengurangan 24,5 persen. Dari sisi kualitas jawaban, nilai GSM8K berubah dari 96,89 menjadi 96,82 persen. NVIDIA menyatakan, penurunan angka yang kecil itu tidak menunjukkan perbedaan statistik yang jelas. Namun perlu diperhatikan, ketiga optimalisasi harus diintegrasikan dengan benar, karena kesalahan integrasi FP8 dengan NEXTN bisa menghasilkan throughput lebih buruk daripada baseline.
Manfaat Humming FP8 dan NEXTN bagi Pengembangan Kecerdasan Buatan
Penerapan teknik inferensi terbaru NVIDIA memperlihatkan manfaat optimalisasi perangkat lunak dalam pengembangan AI lokal dengan kebutuhan memori tinggi. Berkat optimalisasi backend MoE, beban operasi MoE berhasil dikurangi. Di sisi pengelolaan memori, penggunaan representasi FP8 untuk lapisan keluaran membantu mengurangi kebutuhan pembacaan data. Integrasi multi-token prediction melengkapi kedua pendekatan tersebut melalui prediksi beberapa token sekaligus. Hasil pengujian menunjukkan kenaikan throughput 42,5 persen dalam pengujian terkontrol pada DGX Spark. Walaupun pencapaian tersebut menjanjikan, performa aktual harus divalidasi untuk setiap aplikasi. Kemajuan TEKNOLOGI inferensi lokal memungkinkan pengembang menjalankan model kompleks dengan kinerja lebih baik. Apa pendapat Anda mengenai peningkatan performa AI melalui Humming dan speculative decoding? Sampaikan pengalaman Anda mengenai masa depan pemrosesan kecerdasan buatan pada perangkat desktop.