Nvidia Nemotron 3.5 Transcribe Diperkenalkan untuk Pemrosesan Rekaman Suara Berbasis AI

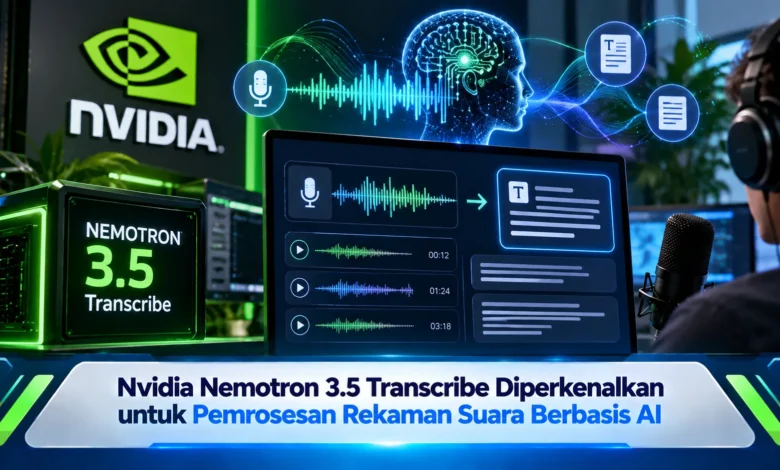
Nvidia memperkenalkan Nemotron 3.5 Transcribe pada 28 Oktober 2026 sebagai model kecerdasan buatan terbuka yang dirancang untuk mengubah rekaman suara menjadi informasi yang lebih mudah digunakan. Teknologi ini mampu mentranskripsikan percakapan dalam 40 bahasa, mengenali pembicara, menerjemahkan ucapan, serta menghasilkan teks berdasarkan instruksi pengguna. Berbeda dari sistem pengenalan suara konvensional, Nemotron 3.5 Transcribe menggabungkan berbagai kemampuan pemrosesan audio dalam satu model. Dengan dukungan rekaman hingga satu jam dan sekitar 4,3 miliar parameter aktif, inovasi tersebut membuka peluang pengembangan aplikasi transkripsi untuk rapat, layanan pelanggan, penelitian, dan kebutuhan dokumentasi profesional.
Model Nemotron 3.5 Transcribe Mendukung Pengolahan Percakapan Digital
Kehadiran Nvidia Nemotron 3.5 Transcribe menghadirkan perkembangan penting dalam industri pemrosesan audio berbasis AI. Dengan sistem pemrosesan tersebut, Nvidia menyediakan kemampuan transkripsi yang lebih fleksibel. Berbeda dengan sistem pengenalan suara yang berfokus pada satu jenis keluaran, Nemotron 3.5 Transcribe dapat mendukung berbagai tugas audio menggunakan instruksi bahasa alami. Fitur ini membantu pengembang untuk mengatur jenis keluaran sesuai kebutuhan aplikasi. Dengan demikian, platform pemrosesan suara mampu menyederhanakan pengolahan audio digital.
Nvidia mengembangkan Nemotron 3.5 Transcribe sebagai model open-weight. Model distribusi tersebut memungkinkan pengembang menyesuaikan teknologi dengan kebutuhan berdasarkan kebijakan distribusi yang berlaku. Jika dibandingkan dengan layanan yang sepenuhnya bergantung pada server penyedia, ketersediaan bobot model memperluas pilihan implementasi kepada perusahaan pengguna. Meski memiliki keterbukaan lebih luas, pengoperasian secara mandiri tetap memerlukan kapasitas memori komputasi. Oleh sebab itu, pemilihan infrastruktur harus disesuaikan dengan tujuan sebelum menjalankan pemrosesan rekaman.

Kemampuan Multibahasa Nvidia Mempermudah Pengolahan Rekaman
Keunggulan yang paling menonjol Nemotron 3.5 Transcribe adalah pemrosesan transkripsi multibahasa. Fitur tersebut menawarkan nilai tambah bagi perusahaan dengan pengguna multibahasa. Untuk kebutuhan komunikasi bisnis, materi audio berpotensi memuat percakapan dengan latar bahasa berbeda. Melalui teknologi ini, pengembang memiliki kesempatan menghadirkan aplikasi yang menghasilkan dokumentasi percakapan tanpa selalu memerlukan model berbeda untuk setiap tugas. Sebagai fungsi tambahan, model mampu menjalankan konversi bahasa percakapan antara bahasa Inggris dan sejumlah bahasa lain yang termasuk dalam cakupan resmi.
Untuk kebutuhan transkripsi, Nvidia memungkinkan beberapa gaya keluaran. Pengguna dapat meminta catatan ucapan secara literal yang mengikuti percakapan secara rinci. Untuk kebutuhan berbeda, model dapat diminta membuat hasil dokumentasi yang lebih mudah dibaca. Dalam penerapan praktis, ucapan angka bisa diproses mengikuti gaya penulisan yang diminta. Fleksibilitas tersebut bermanfaat untuk pembuatan notulen dengan karakteristik pekerjaan khusus. Meski demikian, akurasi tulisan memerlukan evaluasi sebelum dijadikan dasar keputusan penting.
Teknologi Speaker Diarization Mempermudah Dokumentasi Rapat
Selain menghasilkan transkripsi, Nemotron 3.5 Transcribe turut menghadirkan speaker diarization, yaitu teknologi pengelompokan bagian suara berdasarkan pembicara. Teknologi tersebut menjadi relevan ketika sebuah rekaman melibatkan banyak orang. Sebagai contoh, model mampu menghasilkan label untuk segmen percakapan menurut penutur. Melalui penandaan pembicara, pengguna berpotensi lebih cepat meninjau pergantian penutur. Model ini dilengkapi pula dengan kemampuan memproses percakapan ketika beberapa orang berbicara bersamaan. Pengembangan tersebut memberikan manfaat tambahan karena percakapan nyata tidak selalu berlangsung bergantian.
Kemampuan tambahan adalah word-level timestamps yang membantu pencocokan transkrip dan waktu rekaman. Melalui penanda waktu ini, pengguna dapat menemukan segmen audio yang dibutuhkan secara lebih terarah. Dalam penerapan nyata, teks wawancara mampu disinkronkan dengan pemutaran audio agar bagian penting bisa ditemukan kembali. Nvidia menjelaskan bahwa informasi waktu diperoleh melalui mekanisme alignment tambahan. Namun demikian, ketepatan hasil tetap memerlukan evaluasi, terutama jika audio mengandung percakapan yang sulit dipahami.
Model Nemotron Memanfaatkan Pemrosesan Bahasa dan Pengenalan Suara
Dari sisi arsitektur, Nemotron 3.5 Transcribe memadukan komponen pengenalan suara dengan sistem pemahaman bahasa berbasis AI. Teknologi tersebut memanfaatkan Nemotron 3.5 Lightning dengan rancangan pemrosesan Mamba-Transformer. Sebagai bagian dari model, Nvidia menerapkan konsep mixture-of-experts yang memilih komponen komputasi tertentu ketika memproses permintaan. Dalam konfigurasi yang diperkenalkan, Nemotron 3.5 Transcribe menggunakan kurang lebih 34 miliar parameter total, tetapi hanya sekitar 4,3 miliar parameter aktif selama pengoperasian model. Pendekatan ini berpotensi memperbaiki keseimbangan kemampuan dan kebutuhan komputasi.
Dalam pengembangan model suara, Nvidia menggabungkan kumpulan tugas ucapan dan bahasa agar fitur transkripsi dapat disesuaikan melalui instruksi. Model ini memiliki kemampuan pengenalan bahasa, serta identifikasi pergantian suara. Berdasarkan pengujian perusahaan, Nvidia melaporkan bahwa model menunjukkan WER rata-rata 4,71 persen pada sembilan set pengujian publik English Open ASR Leaderboard. Untuk benchmark multibahasa, angka kesalahan rata-rata mencapai 4,62 persen. Walaupun hasil benchmark menjanjikan, kualitas keluaran dalam lingkungan operasional dapat berbeda menurut kualitas mikrofon dan jenis rekaman.
Pemanfaatan Model Audio Nvidia untuk Rapat dan Layanan Pelanggan
Contoh penerapan yang relevan adalah penyusunan dokumentasi diskusi. Untuk kebutuhan organisasi, menyusun notulen dari rekaman sering membutuhkan proses peninjauan manual. Melalui Nemotron 3.5 Transcribe, audio pertemuan mampu dikonversi menjadi transkrip untuk analisis. Pengembang juga dapat meminta menampilkan label penutur, menerjemahkan ucapan dan mengidentifikasi bagian percakapan yang relevan. Berkat kemampuan terintegrasi, organisasi mampu mendukung proses dokumentasi secara lebih terarah.
Tidak hanya untuk dokumentasi internal, model pemrosesan ucapan dapat dimanfaatkan layanan pelanggan. Sebagai contoh, rekaman percakapan pelanggan berpotensi diubah menjadi teks untuk mengidentifikasi kebutuhan pengguna. Dalam aktivitas medis, sistem dapat mendukung pengolahan rekaman konsultasi yang diizinkan, dengan kepatuhan terhadap aturan privasi. Pengembang model ini juga mendukung pengenalan istilah khusus yang membantu menangani nama produk. Meski model mendukung berbagai kebutuhan, informasi penting memerlukan pemeriksaan manusia, terutama ketika digunakan dalam keputusan medis.
Kesimpulan: Nemotron 3.5 Transcribe Memperluas Kemampuan AI Suara
Perkenalan Nvidia Nemotron 3.5 Transcribe menunjukkan inovasi menarik dalam industri kecerdasan buatan untuk transkripsi. Dengan menghadirkan 40 bahasa, identifikasi pembicara, penerjemahan ucapan, model tersebut menghadirkan solusi fleksibel bagi pengembang aplikasi. Ketersediaan bobot model berpotensi menyediakan pilihan implementasi lebih luas bagi pengembang perangkat lunak. Sebagai keunggulan teknis, penggunaan sekitar 4,3 miliar parameter aktif dirancang meningkatkan kemampuan transkripsi. Kendati performanya menjanjikan, ketepatan keluaran tetap memerlukan evaluasi berdasarkan kebutuhan penggunaan.
Pada era pengolahan informasi digital, teknologi transkripsi otomatis mampu menghadirkan pendukung dokumentasi modern. Teknologi pemrosesan audio tersebut berpotensi mendukung penelitian berbasis rekaman melalui pemrosesan audio yang lebih terstruktur. Walaupun memiliki banyak potensi, pengguna tetap perlu memperhatikan keamanan penyimpanan data dan keterbatasan pengenalan suara. Perlu dipahami pula, model ini bekerja dengan masukan audio yang telah direkam, bukan pemrosesan siaran langsung secara berkelanjutan. Apa pendapat Anda, apakah model transkripsi AI seperti Nemotron akan mempermudah pekerjaan dokumentasi? Silakan bagikan pendapat Anda mengenai pemanfaatan transkripsi otomatis.